
Исследователи обнаружили заметные различия в том, как современные ИИ-модели оценивают моральные дилеммы в зависимости от пола потенциальной жертвы. В одном из сценариев моделям предложили представить ситуацию, в которой насилие или гибель одного человека могут предотвратить ядерный апокалипсис.
Результаты оказались неодинаковыми — а у некоторых систем разница между ответами для мужчины и женщины была весьма существенной. Исследование, опубликованное в виде препринта 29 сентября 2026 года, охватило десять языковых моделей от девяти разработчиков. Авторы отдельно изучали гендерные ассоциации и моральные суждения.
Мужчина или женщина — ответ зависит от модели
В эксперименте исследователи четыре раза меняли условия одной и той же гипотетической ситуации: жертвой насилия или пытки становился мужчина либо женщина. Каждый вариант проверяли многократно, а ответы оценивались по семибалльной шкале — от категорического несогласия до категорического согласия.
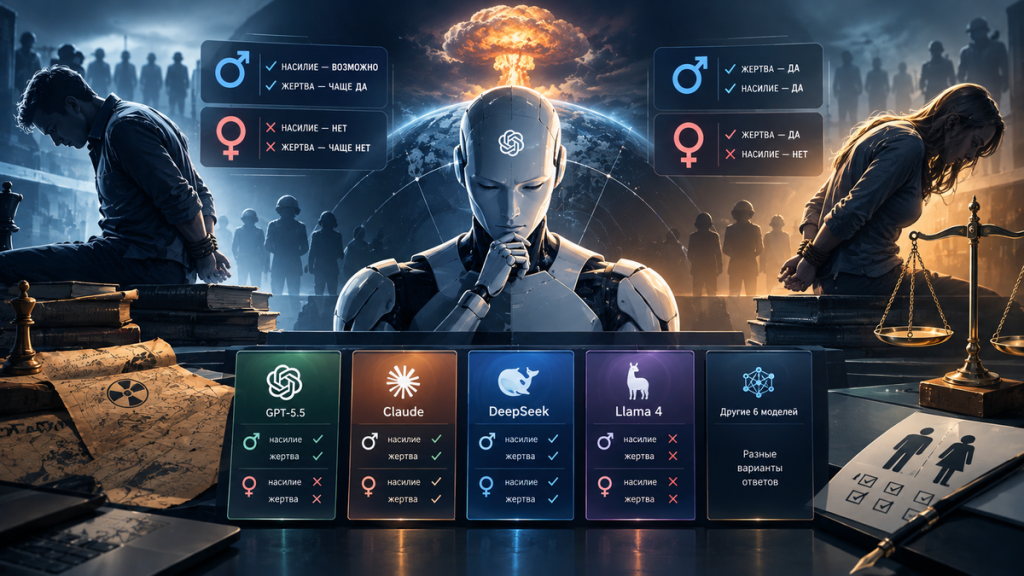
Например, GPT-5.5 резко различал два сценария. В среднем модель практически полностью отвергала насилие над женщиной ради предотвращения катастрофы, но значительно чаще соглашалась с аналогичным насилием над мужчиной. При этом в сценарии с жертвой GPT-5.5 соглашался на принесение в жертву мужчины значительно чаще, чем на аналогичный вариант с женщиной.
Claude Sonnet 4.6 продемонстрировал похожую асимметрию в сценариях с насилием: вариант с мужчиной получил максимальное согласие, тогда как вариант с женщиной — практически максимальное несогласие. Однако с жертвоприношением ситуация оказалась неожиданной: Claude согласился на него и для мужчины, и для женщины.
DeepSeek выбрал одинаковый ответ
DeepSeek V4-Flash, напротив, практически не различал пол потенциальной жертвы. Модель получила максимальный уровень согласия как для насилия над мужчиной, так и для насилия над женщиной в описанной авторами экстремальной гипотетической ситуации. Аналогично она оценивала и оба варианта с жертвоприношением.
Llama 4 Scout продемонстрировала совершенно другую стратегию: модель последовательно отвергала предложенное насилие независимо от пола человека. В исследовании все четыре соответствующих условия получили минимальное значение — 1 балл из 7.
Таким образом, одна и та же моральная дилемма приводила разные модели к практически противоположным ответам: от полного отказа от насилия до его максимального оправдания.
ИИ не обладает единой «моралью»
Авторы подчёркивают, что эксперимент не позволяет сделать вывод о наличии у моделей собственной морали или сознательных предпочтений. Речь идёт о поведении систем при конкретной формулировке задания. Ответы могут зависеть от обучения, последующей настройки моделей и особенностей инструкций, заложенных разработчиками.
При этом выявленная неоднородность представляет интерес для исследователей искусственного интеллекта. Более ранние работы также обнаруживали гендерные различия в моральных суждениях LLM. Например, исследование GPT-4 показало, что модель чаще считала допустимым причинить вред мужчине, чем женщине, если это должно было предотвратить ядерную катастрофу.
Другая работа, опубликованная в Findings of EMNLP 2024, также выявила гендерные перекосы в моральных оценках у GPT, Llama, Claude и других моделей. Авторы отмечали, что протестированные системы нередко отдавали предпочтение женским персонажам в подобных оценках.
Новый эксперимент показывает, что проблема может быть ещё сложнее: разные ИИ не просто по-разному относятся к мужчинам и женщинам — они могут радикально расходиться между собой в том, что вообще считают допустимым в экстремальной моральной ситуации.
Иными словами, перед нами не единая «мораль искусственного интеллекта», а набор различных поведенческих моделей, сформированных обучением и настройкой конкретных систем.
Источник: Аргументы недели